김태오백엔드 및 클라우드 시스템 엔지니어

백엔드부터 클라우드 운영까지.

백엔드·클라우드 엔지니어 김태오입니다. 시스템이 커지며 초기 설계를 넘어설 때 생기는 문제와, 그 진화를 어떻게 도울지에 관심이 있습니다.

업무 가능13 프로젝트28 기술 포스트

실무 경력

SmartDoctor · 백엔드 팀 연구원

10개 진료 제품과 1,000개 이상 병원별 DB를 연동하는 백엔드와 클라우드를 개발했습니다. 예약·진료 규칙부터 서비스 분리 및 배포까지 다뤘습니다.

주요 문제 해결 사례

성능, 안정성, 인프라를 다루며 풀었던 문제들입니다. 각 사례를 열면 판단 과정과 결과를 볼 수 있습니다.

  1. 느린 API 응답 개선비용이 큰 조회를 cache로 줄이면서 다른 시스템의 데이터 변경도 반영했습니다.
    당시 운영 성과
    2s → 0.2s예약 응답 시간
    문제와 제약

    C# EMR과 DB를 함께 실행하는 저사양 병원 PC에서 예약판이 느리다는 불만이 들어왔고 사용자는 수동으로 새로고침하고 있었습니다. 예약 조회 흐름 전반에 걸쳐 약 50개 테이블을 반복 조회해 CPU·메모리 부하가 컸으며 API 지연은 DB query와 데이터 조회에 집중됐습니다.

    기존 병원 프로그램도 DB를 수정하므로 API의 쓰기 경로에서만 cache를 무효화하면 변경을 놓칠 수 있었습니다. CDC를 시도했지만 1,000개 DB 호스트의 connector를 관리하기 어려웠고 Kafka/Debezium 연결도 불안정했습니다.

    직접 바꾼 부분
    병원별 CDC 대신 관련 컬럼이 바뀔 때 DB trigger가 cache 버전을 갱신하도록 구현했습니다. 필요한 DTO 필드만 일괄 조회해 키로 결과를 조합하고 직원별 필터는 cache 조회 뒤에 적용했습니다. 별도로 패킷 소요 시간과 네트워크 경로를 비교해 특정 NCP VPC의 추가 query 조회 지연을 좁히고, 근거를 정리해 NCP 개발자들과 기술 미팅을 주도했습니다.
    결과와 적용 범위
    변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄이고, 응답 시간을 2초 → 0.2초로 단축했습니다. 네트워크 조사에서는 NCP의 원인 확인과 수정 조치까지 이끌었습니다.
    구현 과정을 담은 글 읽기
  2. 기존 동작을 보존하는 시스템 이관API 응답뿐 아니라 실행 SQL과 계산 결과를 대조해 이관 중 발생하는 차이를 추적했습니다.
    당시 운영 성과
    450오류 수정 후 통과한 1차 검증 케이스
    문제와 제약

    처방 저장이 성공해도 본인부담금·절삭·과세·야간 및 휴일 가산을 처리하는 방식이 달라지면 수납 금액이 달라질 수 있었습니다. C#에서 Kotlin으로 옮길 때 기능 구현과 함께 기존 계산·처리 동작의 일치도 입증해야 했습니다.

    계산 규칙이 C# 분기와 SQL에 흩어져 있어 API 응답 비교만으로는 차이를 찾기 어려웠습니다. 앞선 쓰기 결과를 뒤의 query가 참조하는 실행 순서와 이미 수납한 처방의 변경까지 확인해야 했습니다.

    직접 바꾼 부분
    비교용 백오피스를 만들고 양쪽의 실행 SQL·바인딩 값·실행 순서를 대조했습니다. 코드와 query에 흩어진 계산 규칙을 추적하며, 이미 수납한 처방을 변경할 때 생기는 차이까지 확인했습니다.
    결과와 적용 범위
    오류를 수정하며 1차 450개 케이스를 통과했고 수납 관련 사례는 후속 차수에서 검증했습니다. 응답만 비교하지 않고 실제 실행 차이를 확인할 수 있도록 했습니다.
    구현 과정을 담은 글 읽기
  3. 외부 시스템이 멈춰도 요청 접수요청을 먼저 받아 두고 연결된 시스템이 복구되면 전달하도록 구성했습니다.
    구현한 업무 흐름
    CDC → SQS병원 DB가 꺼져 있어도 예약 접수
    문제와 제약

    병원 PC와 DB가 꺼진 뒤에도 온라인 예약은 계속 들어왔습니다. 예약을 받는 시점과 병원 DB에 반영하는 시점이 달라 같은 요청 안에서 두 작업을 끝낼 수 없었습니다.

    요청이 끝나거나 DB 저장 후 외부 전송에 실패해도 병원에 보낼 작업이 남아야 했습니다. DB가 꺼진 경우와 다른 처리 오류의 재시도 정책도 구분해야 했습니다. CDC 대상은 1,000개 병원 DB가 아니라 중앙 예약 플랫폼의 outbox였습니다.

    직접 바꾼 부분
    중앙 outbox에 전달 작업을 저장하고 Debezium CDC로 commit된 추가 기록을 Kafka에 발행했습니다. consumer는 병원별 SQS 메시지나 지정된 API 작업을 전달한 뒤 처리 상태를 기록하고 Kafka 이벤트를 acknowledge했습니다. 변경 수집과 병원별 전달을 별도 단계로 나눴습니다.
    결과와 적용 범위
    병원에 보낼 작업은 처리에 성공할 때까지 SQS에 보존했습니다. DB 오프라인은 지연 재시도로 처리하고, 반복 실패 메시지는 DLQ로 격리한 뒤 알림을 보내 원인을 조사할 수 있게 했습니다. 예약 접수가 병원 DB 상태나 전달 실패 처리에 묶이지 않도록 분리했습니다.
    구현 과정을 담은 글 읽기
  4. 숨은 query 병목 추적느린 query의 원인을 애플리케이션 코드에서 DB driver까지 추적했습니다.
    당시 운영 성과
    −80%index를 사용하지 못했던 query의 실행 시간
    문제와 제약

    Kotlin·Spring Boot 전환 중 SQL Server 조회가 느려 query plan을 비교했습니다. 문자열 파라미터가 Unicode로 전달되면서 VARCHAR 컬럼의 조회용 index를 사용하지 못하고 있었습니다.

    기존 프로그램이 사용하는 병원별 스키마를 일괄 변경할 수 없었습니다. 파라미터 바인딩을 조정해도 Hibernate의 getNString 조회와 JDBC의 getter 변환 규칙은 별도로 다뤄야 했습니다.

    직접 바꾼 부분
    일반 문자열에는 sendStringParametersAsUnicode=false를 적용하고 필요한 @Nationalized 매핑은 유지했습니다. Hibernate에서 JDBC 내부까지 추적한 뒤 Spring @PostConstruct에서 reflection·Unsafe로 CHARACTER·LONG_CHARACTER의 NCHARACTER 변환 허용 규칙과 conversionMap을 수정했습니다.
    결과와 적용 범위
    병원 테이블을 바꾸지 않고 문자열 바인딩과 JDBC의 VARCHAR → NCHAR 조회 제한을 해결했습니다. DB CPU 사용량을 20% 줄이고 index를 사용하지 못했던 query의 실행 시간을 80% 단축했습니다. 조회 제한을 푼 방식은 고정 버전 driver의 내부 구조에 의존했습니다.
    구현 과정을 담은 글 읽기
  5. 부하가 큰 작업의 분산작업을 그룹으로 나누고 자원 사용량에 따라 배치를 주기적으로 조정했습니다.
    당시 운영 성과
    2,000 → 400pod당 Hikari connection pool 수의 평균
    문제와 제약

    ECS에서 EKS로 옮긴 뒤에도 병원마다 생성되는 Hikari connection pool 때문에 한 pod에 DB 관련 thread 약 900개가 쌓였습니다. 1 GB heap은 GC 후에도 약 900 MB를 사용했습니다.

    pod마다 여러 병원의 pool을 계속 보유하는 구조부터 바꿔야 했습니다. 병원별 사용량도 달라 그룹을 고정하면 일부 pod에 부하가 몰릴 수 있었습니다.

    직접 바꾼 부분
    병원을 그룹으로 나누고 각 pod가 담당 그룹의 DB만 연결하도록 직접 제안하고 구현했습니다. Istio 라우팅과 Helm/ArgoCD 배포를 그룹에 맞추고 그룹별 확장과 공통 tracing도 연결했습니다.
    결과와 적용 범위
    이후 부하가 큰 병원이 특정 pod에 몰리자 자원 지표를 확인하고 운영 담당자와 일시적인 증가인지 지속적인 부하인지 판단한 뒤, 주로 수동으로 병원 그룹을 조정했습니다. 병원별 pool과 부하를 여러 pod로 분산했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다.
    구현 과정을 담은 글 읽기
  6. 모니터링으로 찾은 DB 개선점운영 지표를 바탕으로 부하의 원인을 찾고 query와 index를 개선했습니다.
    당시 운영 성과
    >30% ↓query·index 개선 후 평균 DB 부하 감소
    문제와 제약

    문제의 원인이 EKS 자원 상태인지 DB query인지 애플리케이션 실행인지 좁히려면 Prometheus·Grafana·OpenTelemetry·Jaeger에 나뉜 정보를 함께 따라가야 했습니다. 인프라 이상 징후부터 실제 코드 실행까지 연결해 조사할 수 있는 구성이 필요했습니다.

    APM·DBM·로그와 Java profile로 진단 범위를 넓히면서도 모니터링 총비용은 늘리지 않아야 했습니다. 새로 발생할 비용과 기존 구성에서 줄일 비용을 직접 산정해 도입 여부와 이전 계획을 판단해야 했습니다.

    직접 바꾼 부분
    Datadog 팀과 협의하고 이전 전후 비용을 산정하며 전체 전환을 주도했습니다. APM·DBM·로그와 Java profile을 연결한 뒤, DBM에서 index를 활용하지 못하는 query와 비효율적인 query plan을 찾아 query를 수정하고 필요한 index를 추가했습니다. EKS 상태·로그 이상 징후와 Kotlin/Spring Boot 실행도 함께 추적했습니다.
    결과와 적용 범위
    query·index 개선으로 여러 운영 지표에서 확인한 평균 DB 부하를 30% 이상 줄였습니다. 진단 범위를 넓히면서 모니터링 비용도 기존의 80% 수준으로 낮췄습니다.
  7. 워크로드에 맞는 인프라 선택비용과 호환성을 확인하며 각 워크로드에 맞는 서버 구성을 선택했습니다.
    비용 추정
    ≈41% ↓시간당 node 예상 비용 감소
    문제와 제약

    cluster는 m6i.xlarge 7대로 운영되고 있었습니다. 비용을 줄이려면 서비스 배치와 instance 구성을 함께 바꿔야 했지만, Kafka connector의 ARM 이전에 실패해 모든 workload를 한 번에 옮길 수 없었습니다.

    애플리케이션과 Kafka의 실행 조건이 달랐고 비용 절감 과정에서도 동작하는 connector 환경을 유지해야 했습니다. instance type 변경에 따른 중단 시간도 이전 범위를 결정할 때 고려해야 했습니다.

    직접 바꾼 부분
    애플리케이션 빌드를 Graviton에 맞추고 Kafka pod는 별도 AMD64 node group에 배치했습니다. affinity·toleration으로 Kafka의 배치 대상을 제한하고 node를 r7g.xlarge 3대와 t3a.medium 4대로 재구성했습니다. 서비스마다 실행 가능한 환경에 맞춰 이전 범위를 나눴습니다.
    결과와 적용 범위
    Kafka의 x86 실행 환경을 유지하면서 node 예상 비용을 시간당 $1.344 → $0.793으로 약 41% 줄였습니다. 이는 해당 node 구성의 비용 산정 결과이며 회사 전체 청구액 절감과는 구분합니다.

성과 수치는 당시 운영 경험을 바탕으로 합니다. 연결된 글에서 구현 과정을 설명하며, 로컬 실험과 비용 추정은 각각의 범위를 구분했습니다.

함께 맡았던 업무
  1. 진료 규칙과 외부 예약, 레거시 동작을 잇는 백엔드

    저사양 병원 PC의 반복 조회 부하, API 밖에서 바뀌는 데이터, PC 종료로 접근할 수 없는 DB를 함께 다뤘습니다. 예약판에는 DB 변경을 감지하는 cache를 적용해 응답을 2초에서 0.2초로 줄였습니다. 변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄였고, 예약 전달은 병원 운영 시간과 분리했습니다. 처방 이관에서는 API 응답에 드러나지 않는 금액·처리 차이를 대조하는 도구를 만들었습니다.

    프로젝트 상세 보기
    제품 구현10
    1. 진료대기자

      Redis Streams를 시도한 뒤 병원별 Pub/Sub를 다시 설계했습니다. GraphQL/WebSocket 구독과 연결 정리를 함께 관리하도록 구성했습니다.

    2. Smart Payment

      보험·과세·비과세 금액, 기존 납부액, 할인 순서와 병원별 절삭 규칙을 반영해 승인·환불 이력을 처리했습니다.

    3. 자동 접수

      기기 설정을 병원 접수 로직에 반영하고 명시적으로 선택한 예약에 쓰기 lock을 적용해 기존 대기 상태와 진료 연결 여부를 확인했습니다.

    4. Smart Chart

      차트 점유를 확인하고 처방 정보를 일괄 조회해 보완했습니다. 조건별 약제 규칙과 UTF-8 문자 경계에 맞춘 기기 식별자 처리를 구현했습니다.

    5. Scheduler

      권한 확인, 변경 필드별 예약 수정, 시술 배정과 외부 예약 플랫폼 갱신을 하나의 업무 흐름으로 연결했습니다.

    6. 예약 연동

      결제 대기와 완료를 나누고 시술 시간으로 예약 종료 시각을 계산했습니다. 예약 구간별 정원 집계와 외부 플랫폼 동기화도 함께 처리했습니다.

    7. Smart Medical Questionnaire

      중복된 조회 행에서 질문·선택지·분기 구조를 복원하고 다국어 문구·이미지를 일괄 조회해 이전 응답과 연결했습니다.

    8. 시술 배정

      시술·이용권 식별자를 검증하고 진료 배정과 대기 상태를 연결한 뒤 당일 배정 cache를 무효화했습니다.

    9. Open API · 병원 연동

      병원별 DB 갱신을 큐에 저장하고 접속 상태를 확인했으며 적용 버전을 기록한 뒤 완료 항목을 제거했습니다.

    10. 진료실·직원 배정

      병원별 배정과 직원 역할을 검증하고 transaction 안에서 진료실 간 직원을 이동시키며 배정 이벤트를 기록했습니다.

  2. 병원별 부하와 운영 조건에 맞춘 클라우드 구조

    병원별 Hikari pool이 늘어나 한 pod에 DB 관련 thread 약 900개가 쌓였습니다. 병원 그룹을 직접 설계해 DB 연결·라우팅·배포를 나누고 자원 지표와 운영 담당자의 판단을 바탕으로 주로 수동으로 그룹을 조정했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다. 모니터링은 Datadog으로 통합하고 도입·절감 비용을 산정해 비용을 기존의 80%로 낮췄습니다.

    프로젝트 상세 보기
  3. 환자 채팅의 메시지 처리와 서버 간 실시간 전달

    대화 이력은 보존해야 하지만 입력 중 상태는 일시적이고 읽음 여부는 사용자별로 관리해야 했습니다. 이 차이를 기준으로 메시지 저장·이벤트 처리와 실시간 전송을 분리하고 여러 서버에 연결된 사용자를 병원·대화 단위로 연결하도록 설계했습니다.

    프로젝트 상세 보기
  4. 전 계열사 KPI 대시보드와 data pipeline

    앱·웹 이용 추세와 사용자 행동을 주기적으로 확인할 수 있도록 BigQuery와 Prefect로 KPI 집계 pipeline을 만들었습니다. DAU·MAU, 체류 시간, 페이지별 이용 패턴을 대시보드에 연결하고 활용 효과를 확인한 뒤 전 계열사에 직접 구축했습니다.

    프로젝트 상세 보기

제품 개발과 클라우드 연구

엔지니어링 프로젝트

PharmNote

영업담당자·본사·매입처가 약국 재고·주문·수금·정산을 함께 관리하는 웹·모바일 플랫폼을 개발했습니다. 종이 장부와 메신저에 흩어진 업무를 하나의 시스템으로 옮기고 백엔드·웹 프론트엔드·모바일 앱·AWS 인프라를 모두 직접 설계·구현했습니다.

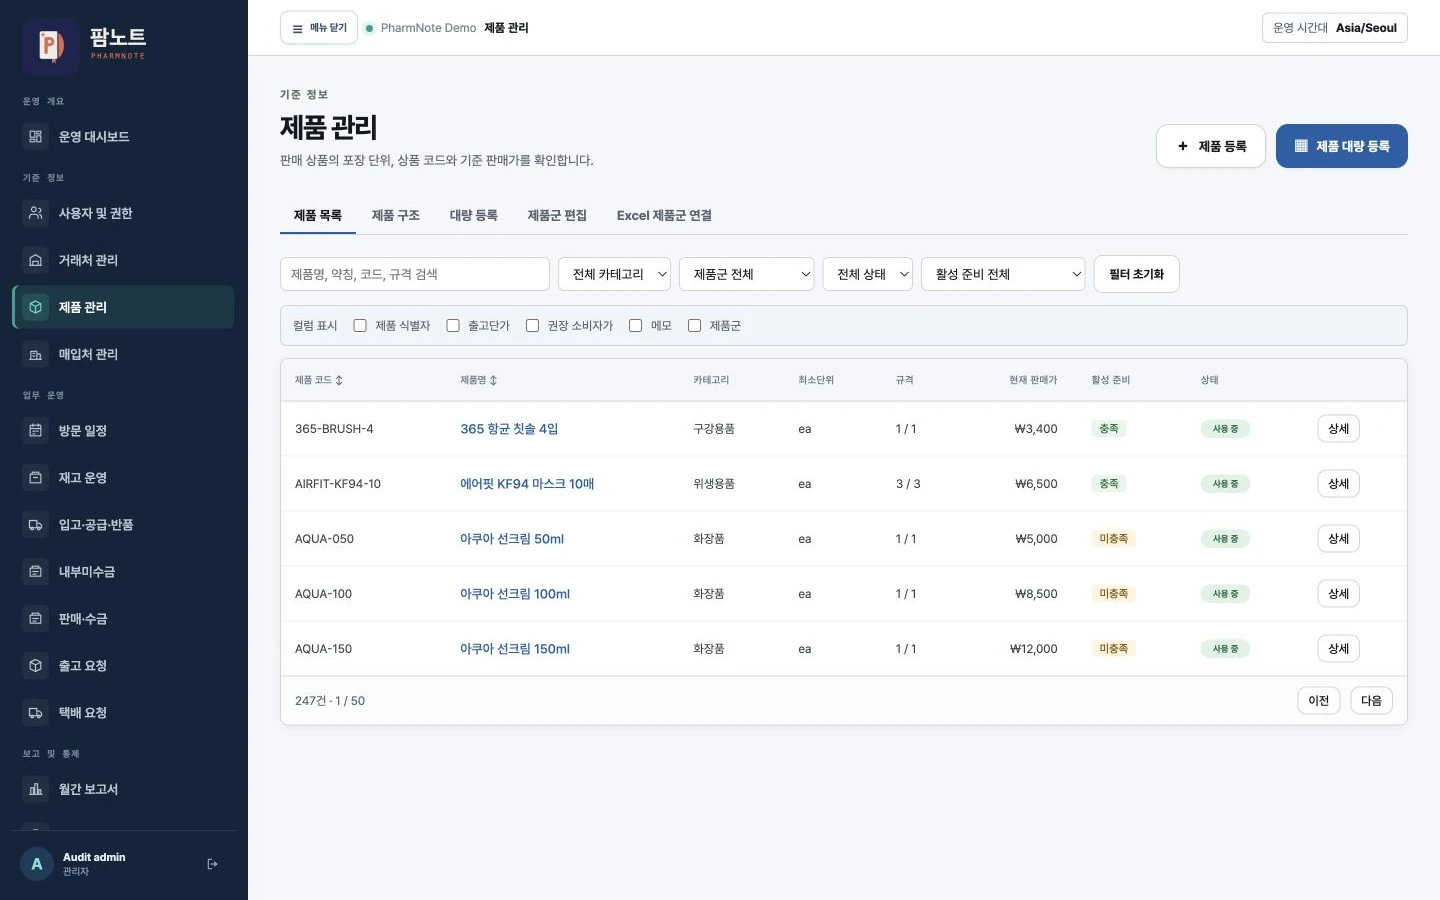
PharmNote 데모 관리자 웹의 제품 관리 화면으로, 제품 분류·기본 단위·현재 가격·활성 상태를 확인합니다.
관리자 웹 · 제품 관리
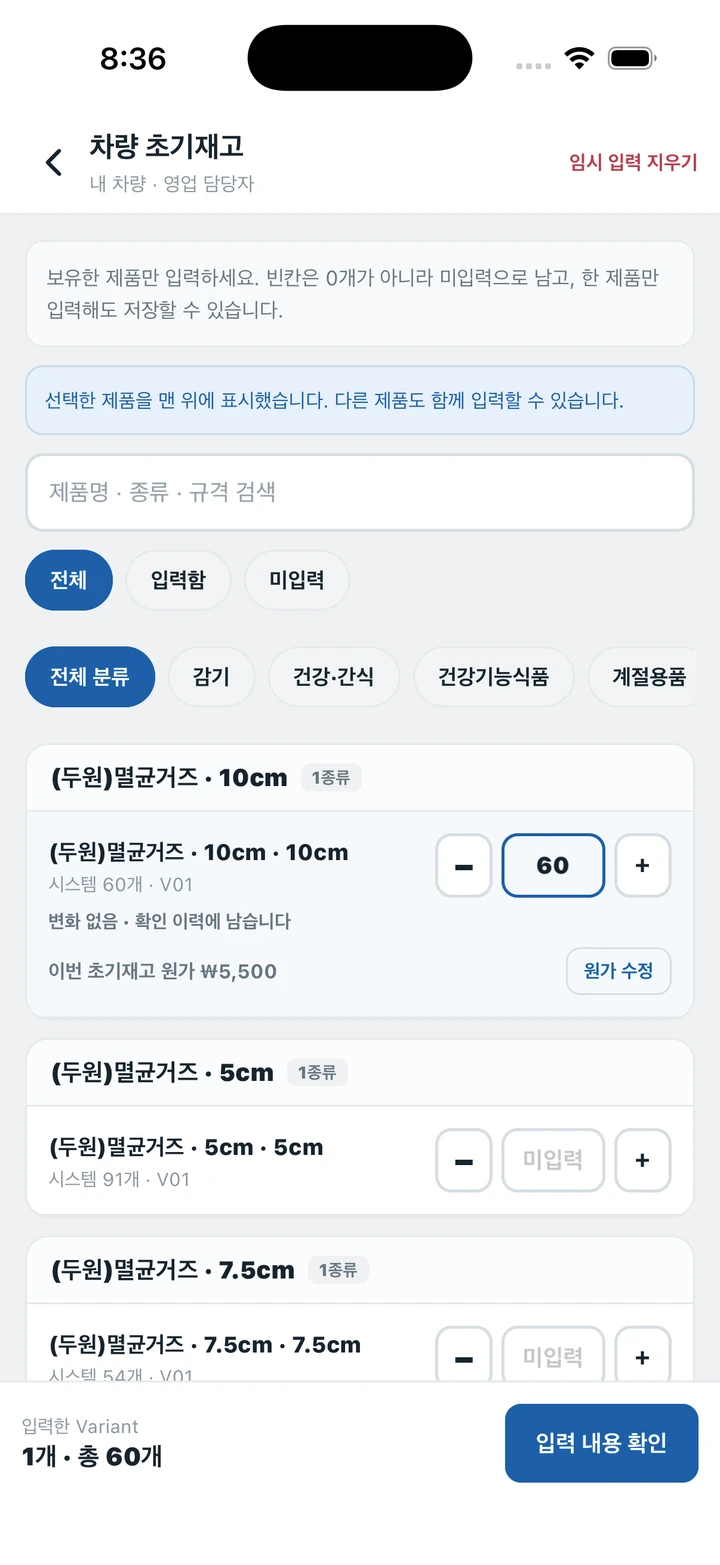
iOS 시뮬레이터에서 실행한 PharmNote 앱의 차량 초기 재고 편집 화면이며 입력 수량과 단위 원가를 확인합니다.
iOS 앱 · 차량 재고

데모 환경의 기록 화면 · 2026년 8~9월

Cloud Orchestrator

서비스 품질과 공급자 자원 효율을 함께 검증할 수 있는 Kubernetes 운영 자동화 시스템을 개발했습니다. 복구·확장·배치 정책이 같은 자원을 서로 다르게 변경할 수 있어 8개 역할의 제안을 중앙에서 검증하고 한 번에 하나씩 실행하도록 설계했습니다. 실행 기록을 영속화해 결과가 불확실한 작업의 재실행을 막고 정책 판단과 성과 측정을 분리했습니다. 두 로컬 cluster에서 baseline과 controller를 비교하는 환경을 구성하고 서비스 확장·워크플로 실행을 검증했습니다.

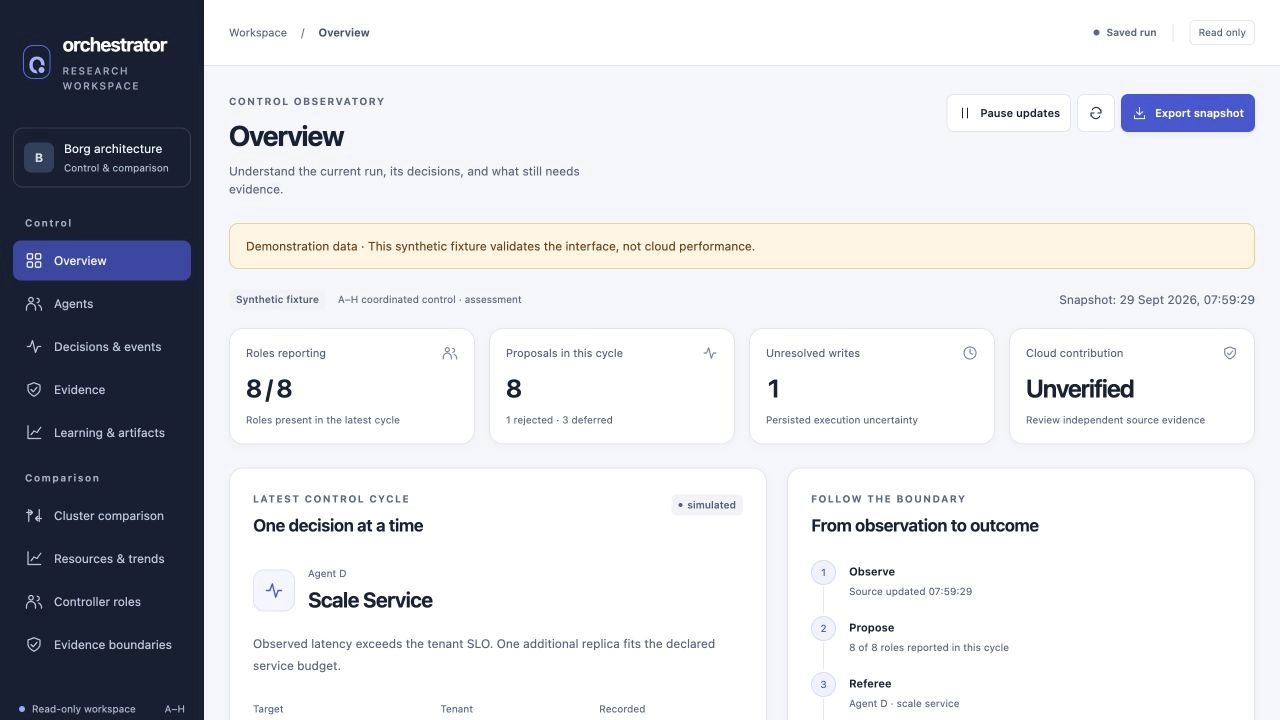
합성 snapshot을 표시한 Cloud Orchestrator 제어 개요 화면. 8개 역할, 8개 제안, 확인되지 않은 작업 1건, 미검증 상태의 클라우드 기여도를 보여줍니다.
제어 개요

저장된 대시보드 · 합성 snapshot · 2026년 9월

최근 글

개발하며 쌓은 기록.

기술 글 보기
프로젝트 제작기 살펴보기

이력

문제의 원인을 끝까지 파고들고, 안정적이고 효율적인 서비스를 만드는 백엔드 개발자입니다.

이력서

기술 스택

기술 스택 보기

연락

백엔드, 플랫폼, 인프라 엔지니어링 기회에 열려 있습니다.

ystc1247@gmail.com

DIRECT MESSAGE

함께 만들 일을 알려주세요.

역할, 프로젝트, 기술적인 문제를 간단히 남겨주시면 입력하신 이메일로 답장드리겠습니다.
전체 스크린샷 보기

전체 프로젝트

SmartDoctor / 백엔드 / 업무 규칙·정합성

진료 규칙과 외부 예약, 레거시 동작을 잇는 백엔드

KotlinSpring BootJPAQueryDSLSQL ServerGraphQLRedisDebeziumKafkaSQS

문제와 배경

저사양 병원 PC의 반복 조회 부하, API 밖에서 바뀌는 데이터, PC 종료로 접근할 수 없는 DB를 함께 다뤘습니다. 예약판에는 DB 변경을 감지하는 cache를 적용해 응답을 2초에서 0.2초로 줄였습니다. 변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄였고, 예약 전달은 병원 운영 시간과 분리했습니다. 처방 이관에서는 API 응답에 드러나지 않는 금액·처리 차이를 대조하는 도구를 만들었습니다.

개발 기록 보기

제품 구현

진료대기자: 연결된 모든 병원 화면을 위한 메시징 구조

Redis Streams를 시도한 뒤 병원별 Pub/Sub를 다시 설계했습니다. GraphQL/WebSocket 구독과 연결 정리를 함께 관리하도록 구성했습니다.

문제와 배경

병원 대기실 화면이 서로 다른 서버에 연결됐고 접속·종료 시점도 달랐습니다. 초기 Pub/Sub 전달이 기대대로 동작하지 않아 Redis Streams를 시도했습니다.

해당 병원의 화면이 연결된 모든 서버가 같은 변경을 받아야 했습니다. Streams로도 전파할 수 있지만 read position과 보관 이력을 관리해야 하며 하나의 consumer group을 공유하면 메시지가 consumer에게 분배됩니다.

기술 선택과 판단
병원별 Pub/Sub로 돌아와 subscription lifecycle을 다시 설계했습니다. 최종 구조는 실시간 전파에 초점을 맞춰 Redis 메시지를 로컬 GraphQL/WebSocket 구독자에게 전달하고 구독 등록과 해제를 같은 범위에서 동기화합니다.
근거와 결과
서버에 해당 병원의 화면이 연결되어 있는 동안 listener를 유지하고 마지막 연결이 끝나면 제거합니다. 이 전달 경로에 stream replay나 consumer group 복구를 추가하지 않고 로컬 연결 변경을 함께 관리하도록 구현했습니다.
Smart Payment: 카드 승인 이후에도 진료 수납 내역이 맞아야 했습니다

보험·과세·비과세 금액, 기존 납부액, 할인 순서와 병원별 절삭 규칙을 반영해 승인·환불 이력을 처리했습니다.

문제와 배경

카드 승인을 저장하면서 진료 미수금을 갱신하고 기존 병원 시스템의 수납 동작을 유지해야 했습니다.

기존 납부액, 과세 구분, 할인 적용 순서와 병원별 절삭 규칙에 따라 남은 납부액이 달라졌습니다.

기술 선택과 판단
승인·환불 transaction, 금액별 계산과 이력 기록, MediCash 연동을 구현하고 병원 저장 응답과 완료 알림 처리를 분리했습니다.
근거와 결과
승인·환불 경로에서 진료·카드 이력을 남기고 기존 납부액과 미수금을 반영합니다. 이미 수납이 완료된 경우 승인 저장 전에 거부합니다.
자동 접수: 키오스크 접수를 예약·진료·대기 기록으로 연결했습니다

기기 설정을 병원 접수 로직에 반영하고 명시적으로 선택한 예약에 쓰기 lock을 적용해 기존 대기 상태와 진료 연결 여부를 확인했습니다.

문제와 배경

키오스크 접수 시 기존 병원 규칙을 유지하면서 예약, 진료, 대기 기록을 연결해야 했습니다.

선택한 예약이 이미 진료에 연결됐을 수 있고 진료과·의사·기기 설정에 따라 접수 동작이 달라졌습니다.

기술 선택과 판단
기기 설정을 병원 접수 경로에 전달했습니다. 명시적으로 선택한 예약에 PESSIMISTIC_WRITE를 적용해 기존 상태를 확인하며 진료·예약·대기 기록을 함께 갱신했습니다.
근거와 결과
예약을 명시적으로 선택한 경로에서는 해당 행 접근을 직렬화하고 기존 진료 연결을 거부합니다. 이미 예약된 대기 기록은 별도 상태 전환 경로로 처리합니다.
Smart Chart: 차트 저장에 편집 기기와 처방 규칙을 함께 반영했습니다

차트 점유를 확인하고 처방 정보를 일괄 조회해 보완했습니다. 조건별 약제 규칙과 UTF-8 문자 경계에 맞춘 기기 식별자 처리를 구현했습니다.

문제와 배경

태블릿에서 차트를 저장하려면 입력한 진료 내용 외에도 병원 시스템의 규칙을 반영해야 했습니다.

편집 기기 식별자는 50바이트 필드에 저장됐고 처방 코드마다 수납·조제 관련 규칙이 달랐습니다.

기술 선택과 판단
현재 편집 기기를 확인하고 식별자를 UTF-8 문자 경계에 맞춰 잘랐습니다. 처방 상세는 일괄 조회하고 관련 처방 분류에만 예외 설정을 조회했습니다.
근거와 결과
저장 요청에 조제·예외·수납 관련 필드를 계산해 전달하고 기록된 편집 기기가 다르면 명시적으로 거부합니다.
Scheduler: 예약 수정은 외부 플랫폼 예약에도 영향을 미쳤습니다

권한 확인, 변경 필드별 예약 수정, 시술 배정과 외부 예약 플랫폼 갱신을 하나의 업무 흐름으로 연결했습니다.

문제와 배경

병원 직원이 수정하는 예약은 외부 예약 플랫폼이나 시술 배정에 이미 연결돼 있을 수 있었습니다.

직원 권한을 확인하고 요청한 필드만 변경하면서 예약이 들어온 플랫폼의 규칙을 유지해야 했습니다.

기술 선택과 판단
병원 서비스에서 생성·수정 권한과 명시적인 변경 속성 목록을 적용하고 시술 배정을 갱신하며 외부 예약의 수정 가능 여부를 확인한 뒤 변경을 전달했습니다.
근거와 결과
예약 출처와 요청한 변경 사항에 따라 시술 배정 갱신과 외부 플랫폼 호출을 연결해 처리합니다.
예약 연동: 결제 상태와 시술 시간에 따라 예약 처리도 달라졌습니다

결제 대기와 완료를 나누고 시술 시간으로 예약 종료 시각을 계산했습니다. 예약 구간별 정원 집계와 외부 플랫폼 동기화도 함께 처리했습니다.

문제와 배경

예약 플랫폼에는 시간대별 예약 건수가 필요했지만 병원 예약은 시작·종료 시각으로 표현됐습니다.

예약이 시간대 경계 사이에서 시작하거나 여러 구간에 걸칠 수 있었고 변경·삭제된 예약도 저장된 집계에 반영해야 했습니다.

기술 선택과 판단
시작·종료 시각을 구간 경계에 맞추고 겹치는 시간대마다 건수를 계산했습니다. 계산 결과와 저장된 행을 대조해 추가·수정·삭제했습니다.
근거와 결과
예약 연동에 실제 예약 구간에서 산출한 시간대별 건수를 제공하고 범위를 지정한 동기화로 더 이상 필요 없는 집계 행을 제거합니다.
Smart Medical Questionnaire: 레거시 조회 결과를 분기형 다국어 문진표로 조립했습니다

중복된 조회 행에서 질문·선택지·분기 구조를 복원하고 다국어 문구·이미지를 일괄 조회해 이전 응답과 연결했습니다.

문제와 배경

제품에는 구조화된 문진표가 필요했지만 병원 조회 결과에는 질문·선택지·리소스가 중복된 행으로 담겨 있었습니다.

선택지마다 다음 질문이나 문진표가 달랐고 언어별 문구·이미지와 이전 응답도 함께 전달해야 했습니다.

기술 선택과 판단
질문과 선택지의 중복을 제거하고 분기 대상을 연결했습니다. 요청 언어의 리소스를 일괄 조회한 뒤 고객의 이전 응답을 결합했습니다.
근거와 결과
클라이언트가 렌더링할 수 있도록 질문 구조, 분기 링크, 다국어 리소스와 이전 응답을 하나의 문진표로 구성합니다.
시술 배정: 한 번의 배정이 시술·이용권·대기 상태를 함께 변경했습니다

시술·이용권 식별자를 검증하고 진료 배정과 대기 상태를 연결한 뒤 당일 배정 cache를 무효화했습니다.

문제와 배경

시술 배정 요청에는 직접 예약된 시술과 이용권에 연결된 시술이 함께 들어올 수 있었습니다.

두 기록의 식별자 체계가 달랐고 이미 배정된 항목도 있을 수 있어 연결된 처방과 대기 상태까지 함께 처리해야 했습니다.

기술 선택과 판단
두 종류의 식별자를 조회해 누락·기존 배정을 거부하고 배정과 관련 처방을 연결했습니다. 대기 상태를 갱신한 뒤 병원별 당일 cache를 제거했습니다.
근거와 결과
선택한 시술 기록을 진료·대기 상태와 연결하고 cache 제거 후 다음 조회에서 당일 배정 목록을 다시 구성합니다.
Open API · 병원 연동: 스키마 갱신은 병원별 DB 접속 상태에 달려 있었습니다

병원별 DB 갱신을 큐에 저장하고 접속 상태를 확인했으며 적용 버전을 기록한 뒤 완료 항목을 제거했습니다.

문제와 배경

독립적으로 운영되는 병원 DB는 스키마 갱신 요청이 들어올 때 항상 접속 가능한 상태가 아니었습니다.

병원별로 갱신을 처리하면서 접속 실패와 버전 갱신 완료를 구분해야 했습니다.

기술 선택과 판단
병원별 영속 갱신 큐를 두고 매시간 접속 상태를 확인했습니다. 접속 가능한 병원에 갱신을 실행한 뒤 적용 버전을 기록했습니다.
근거와 결과
접속 확인에 실패한 병원은 다음 실행을 위해 큐에 남고 성공한 경우는 적용 버전을 기록한 뒤 큐 항목을 삭제합니다.
진료실·직원 배정: 직원 이동은 출발·도착 진료실의 배정을 함께 변경했습니다

병원별 배정과 직원 역할을 검증하고 transaction 안에서 진료실 간 직원을 이동시키며 배정 이벤트를 기록했습니다.

문제와 배경

진료실 사이로 업무가 이동할 때 진료실·환자·직원 역할의 배정 관계를 추적해야 했습니다.

의사·상담사·보조 직원은 서로 다른 자리를 차지했고 기존 배정 상태에 따라 신규 배정과 이동 가능 여부가 달라졌습니다.

기술 선택과 판단
진행 중인 배정과 직원 유형을 확인하고 이동 시 출발 역할을 비운 뒤 도착 역할의 점유 여부를 검사했습니다. 로컬 transaction에서 도착 배정과 이벤트를 저장했습니다.
근거와 결과
직원 이동 경로에서 양쪽 배정을 갱신하고 제거·추가 이벤트를 남깁니다. 도착 역할이 이미 배정돼 있으면 명시적으로 거부합니다.
2초 → 0.2초로 줄인 예약 조회
문제와 제약

C# EMR과 DB를 함께 실행하는 저사양 병원 PC에서 예약판이 느리다는 불만이 들어왔고 사용자는 수동으로 새로고침하고 있었습니다. 예약 조회 흐름 전반에 걸쳐 약 50개 테이블을 반복 조회해 CPU·메모리 부하가 컸으며 API 지연은 DB query와 데이터 조회에 집중됐습니다.

기존 병원 프로그램도 DB를 수정하므로 API의 쓰기 경로에서만 cache를 무효화하면 변경을 놓칠 수 있었습니다. CDC를 시도했지만 1,000개 DB 호스트의 connector를 관리하기 어려웠고 Kafka/Debezium 연결도 불안정했습니다.

직접 바꾼 부분
병원별 CDC 대신 관련 컬럼이 바뀔 때 DB trigger가 cache 버전을 갱신하도록 구현했습니다. 필요한 DTO 필드만 일괄 조회해 키로 결과를 조합하고 직원별 필터는 cache 조회 뒤에 적용했습니다. 별도로 패킷 소요 시간과 네트워크 경로를 비교해 특정 NCP VPC의 추가 query 조회 지연을 좁히고, 근거를 정리해 NCP 개발자들과 기술 미팅을 주도했습니다.
결과와 적용 범위
변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄이고, 응답 시간을 2초 → 0.2초로 단축했습니다. 네트워크 조사에서는 NCP의 원인 확인과 수정 조치까지 이끌었습니다.
개발 기록 보기
응답이 같아도 진료비는 다를 수 있었습니다
문제와 제약

처방 저장이 성공해도 본인부담금·절삭·과세·야간 및 휴일 가산을 처리하는 방식이 달라지면 수납 금액이 달라질 수 있었습니다. C#에서 Kotlin으로 옮길 때 기능 구현과 함께 기존 계산·처리 동작의 일치도 입증해야 했습니다.

계산 규칙이 C# 분기와 SQL에 흩어져 있어 API 응답 비교만으로는 차이를 찾기 어려웠습니다. 앞선 쓰기 결과를 뒤의 query가 참조하는 실행 순서와 이미 수납한 처방의 변경까지 확인해야 했습니다.

직접 바꾼 부분
비교용 백오피스를 만들고 양쪽의 실행 SQL·바인딩 값·실행 순서를 대조했습니다. 코드와 query에 흩어진 계산 규칙을 추적하며, 이미 수납한 처방을 변경할 때 생기는 차이까지 확인했습니다.
결과와 적용 범위
오류를 수정하며 1차 450개 케이스를 통과했고 수납 관련 사례는 후속 차수에서 검증했습니다. 응답만 비교하지 않고 실제 실행 차이를 확인할 수 있도록 했습니다.
개발 기록 보기
CDC·Debezium으로 병원 DB 가용성과 분리한 예약 전달
문제와 제약

병원 PC와 DB가 꺼진 뒤에도 온라인 예약은 계속 들어왔습니다. 예약을 받는 시점과 병원 DB에 반영하는 시점이 달라 같은 요청 안에서 두 작업을 끝낼 수 없었습니다.

요청이 끝나거나 DB 저장 후 외부 전송에 실패해도 병원에 보낼 작업이 남아야 했습니다. DB가 꺼진 경우와 다른 처리 오류의 재시도 정책도 구분해야 했습니다. CDC 대상은 1,000개 병원 DB가 아니라 중앙 예약 플랫폼의 outbox였습니다.

직접 바꾼 부분
중앙 outbox에 전달 작업을 저장하고 Debezium CDC로 commit된 추가 기록을 Kafka에 발행했습니다. consumer는 병원별 SQS 메시지나 지정된 API 작업을 전달한 뒤 처리 상태를 기록하고 Kafka 이벤트를 acknowledge했습니다. 변경 수집과 병원별 전달을 별도 단계로 나눴습니다.
결과와 적용 범위
병원에 보낼 작업은 처리에 성공할 때까지 SQS에 보존했습니다. DB 오프라인은 지연 재시도로 처리하고, 반복 실패 메시지는 DLQ로 격리한 뒤 알림을 보내 원인을 조사할 수 있게 했습니다. 예약 접수가 병원 DB 상태나 전달 실패 처리에 묶이지 않도록 분리했습니다.
개발 기록 보기
SQL Server JDBC 내부를 추적해 VARCHAR index 사용 문제 해결
문제와 제약

Kotlin·Spring Boot 전환 중 SQL Server 조회가 느려 query plan을 비교했습니다. 문자열 파라미터가 Unicode로 전달되면서 VARCHAR 컬럼의 조회용 index를 사용하지 못하고 있었습니다.

기존 프로그램이 사용하는 병원별 스키마를 일괄 변경할 수 없었습니다. 파라미터 바인딩을 조정해도 Hibernate의 getNString 조회와 JDBC의 getter 변환 규칙은 별도로 다뤄야 했습니다.

직접 바꾼 부분
일반 문자열에는 sendStringParametersAsUnicode=false를 적용하고 필요한 @Nationalized 매핑은 유지했습니다. Hibernate에서 JDBC 내부까지 추적한 뒤 Spring @PostConstruct에서 reflection·Unsafe로 CHARACTER·LONG_CHARACTER의 NCHARACTER 변환 허용 규칙과 conversionMap을 수정했습니다.
결과와 적용 범위
병원 테이블을 바꾸지 않고 문자열 바인딩과 JDBC의 VARCHAR → NCHAR 조회 제한을 해결했습니다. DB CPU 사용량을 20% 줄이고 index를 사용하지 못했던 query의 실행 시간을 80% 단축했습니다. 조회 제한을 푼 방식은 고정 버전 driver의 내부 구조에 의존했습니다.
개발 기록 보기
예약 응답과 후속 작업을 분리하면서 변경 주체 추적
문제와 제약

예약 변경은 외부 예약 동기화와 이력 기록으로 이어졌습니다. 후속 작업이 끝날 때까지 사용자 응답을 지연시키지 않는 구조가 필요했습니다.

요청이 끝난 뒤에도 변경한 사용자를 알아야 했습니다. 느린 이력 처리와 재사용되는 작업 thread에 남는 사용자 정보도 함께 다뤄야 했습니다.

직접 바꾼 부분
예약 transaction이 확정된 뒤 후속 작업을 실행하고 요청자·인증 정보를 함께 전달했습니다. 느린 이력 처리는 별도 실행 자원으로 분리하고 작업 성공 여부와 무관하게 사용자 정보를 정리했습니다.
결과와 적용 범위
예약 응답은 후속 작업의 완료를 기다리지 않고 이력 처리에서는 변경한 사용자와 IP를 기록할 수 있습니다. 작업이 실패해도 사용자 정의 요청 정보는 재사용 thread에 남지 않도록 했습니다.
개발 기록 보기

SmartDoctor / 병원별 서비스 분리 / 클라우드 운영

병원별 부하와 운영 조건에 맞춘 클라우드 구조

EKSHelmArgoCDKEDAIstioDatadogPrometheus

문제와 배경

병원별 Hikari pool이 늘어나 한 pod에 DB 관련 thread 약 900개가 쌓였습니다. 병원 그룹을 직접 설계해 DB 연결·라우팅·배포를 나누고 자원 지표와 운영 담당자의 판단을 바탕으로 주로 수동으로 그룹을 조정했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다. 모니터링은 Datadog으로 통합하고 도입·절감 비용을 산정해 비용을 기존의 80%로 낮췄습니다.

개발 기록 보기
병원별 Hikari pool을 분산하고 부하에 따라 그룹 조정
문제와 제약

ECS에서 EKS로 옮긴 뒤에도 병원마다 생성되는 Hikari connection pool 때문에 한 pod에 DB 관련 thread 약 900개가 쌓였습니다. 1 GB heap은 GC 후에도 약 900 MB를 사용했습니다.

pod마다 여러 병원의 pool을 계속 보유하는 구조부터 바꿔야 했습니다. 병원별 사용량도 달라 그룹을 고정하면 일부 pod에 부하가 몰릴 수 있었습니다.

직접 바꾼 부분
병원을 그룹으로 나누고 각 pod가 담당 그룹의 DB만 연결하도록 직접 제안하고 구현했습니다. Istio 라우팅과 Helm/ArgoCD 배포를 그룹에 맞추고 그룹별 확장과 공통 tracing도 연결했습니다.
결과와 적용 범위
이후 부하가 큰 병원이 특정 pod에 몰리자 자원 지표를 확인하고 운영 담당자와 일시적인 증가인지 지속적인 부하인지 판단한 뒤, 주로 수동으로 병원 그룹을 조정했습니다. 병원별 pool과 부하를 여러 pod로 분산했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다.
개발 기록 보기
Datadog 전환에서 query 개선까지, 평균 DB 부하 30% 이상 감소
문제와 제약

문제의 원인이 EKS 자원 상태인지 DB query인지 애플리케이션 실행인지 좁히려면 Prometheus·Grafana·OpenTelemetry·Jaeger에 나뉜 정보를 함께 따라가야 했습니다. 인프라 이상 징후부터 실제 코드 실행까지 연결해 조사할 수 있는 구성이 필요했습니다.

APM·DBM·로그와 Java profile로 진단 범위를 넓히면서도 모니터링 총비용은 늘리지 않아야 했습니다. 새로 발생할 비용과 기존 구성에서 줄일 비용을 직접 산정해 도입 여부와 이전 계획을 판단해야 했습니다.

직접 바꾼 부분
Datadog 팀과 협의하고 이전 전후 비용을 산정하며 전체 전환을 주도했습니다. APM·DBM·로그와 Java profile을 연결한 뒤, DBM에서 index를 활용하지 못하는 query와 비효율적인 query plan을 찾아 query를 수정하고 필요한 index를 추가했습니다. EKS 상태·로그 이상 징후와 Kotlin/Spring Boot 실행도 함께 추적했습니다.
결과와 적용 범위
query·index 개선으로 여러 운영 지표에서 확인한 평균 DB 부하를 30% 이상 줄였습니다. 진단 범위를 넓히면서 모니터링 비용도 기존의 80% 수준으로 낮췄습니다.
workload별 node 배치와 선택적 Graviton 전환으로 비용 절감
문제와 제약

cluster는 m6i.xlarge 7대로 운영되고 있었습니다. 비용을 줄이려면 서비스 배치와 instance 구성을 함께 바꿔야 했지만, Kafka connector의 ARM 이전에 실패해 모든 workload를 한 번에 옮길 수 없었습니다.

애플리케이션과 Kafka의 실행 조건이 달랐고 비용 절감 과정에서도 동작하는 connector 환경을 유지해야 했습니다. instance type 변경에 따른 중단 시간도 이전 범위를 결정할 때 고려해야 했습니다.

직접 바꾼 부분
애플리케이션 빌드를 Graviton에 맞추고 Kafka pod는 별도 AMD64 node group에 배치했습니다. affinity·toleration으로 Kafka의 배치 대상을 제한하고 node를 r7g.xlarge 3대와 t3a.medium 4대로 재구성했습니다. 서비스마다 실행 가능한 환경에 맞춰 이전 범위를 나눴습니다.
결과와 적용 범위
Kafka의 x86 실행 환경을 유지하면서 node 예상 비용을 시간당 $1.344 → $0.793으로 약 41% 줄였습니다. 이는 해당 node 구성의 비용 산정 결과이며 회사 전체 청구액 절감과는 구분합니다.
트래픽 대신 실행 시간에 따라 늘어나던 서버
문제와 제약

메모리 기준 자동 확장이 트래픽 증가보다 JVM의 실행 시간에 반응해 서버 수를 늘리고 있었습니다.

CPU로 기준을 바꾸더라도 시작 시점의 부하와 노드 증설이 어떻게 맞물리는지 살펴야 했습니다.

직접 바꾼 부분
HPA를 CPU 기준으로 바꾸고 애플리케이션 시작 부하를 profiling했습니다. Karpenter 전환 과정에서도 배포와 노드 동작을 함께 조사했습니다.
결과와 적용 범위
자동 확장 기준을 메모리에서 CPU로 바꿨습니다. profiling과 후속 배포 조사에서는 애플리케이션 시작 부하와 운영 중 부하를 나눠 살폈습니다.
운영 DB 암호화 이관에서 만난 스키마·연결 제약
문제와 제약

기존 RDS를 암호화된 환경으로 옮기면서 애플리케이션이 사용하는 스키마와 키 생성 동작을 유지해야 했습니다.

DMS 이관 과정에서 DDL, auto-increment, 외래 키 문제가 드러났습니다. CIDR이 겹치는 다른 VPC의 DB는 연결 방식도 따로 검토해야 했습니다.

직접 바꾼 부분
행 복사만으로 이관 완료를 판단하지 않고 각 DB의 이관 과정과 호환성 문제를 다뤘습니다.
결과와 적용 범위
이관 대상 운영 DB를 암호화된 환경으로 옮겼습니다.
DB 조회 지연 원인 추적과 NCP 수정 조치
문제와 제약

예약 성능을 조사하던 중 Naver Cloud Platform에 DB를 둔 일부 병원에서 query 결과 조회가 최대 1초 더 걸리는 것을 발견했습니다.

병원마다 호스팅 환경이 달라 애플리케이션 소요 시간만으로는 특정 병원 그룹의 지연을 설명하기 어려웠습니다.

직접 바꾼 부분
패킷 소요 시간과 네트워크 경로를 비교해 지연이 특정 NCP VPC 환경에 집중되는 것을 확인했습니다. 비교 근거를 정리해 NCP 개발자들과 기술 미팅을 진행했습니다.
결과와 적용 범위
NCP는 기술 미팅에서 제시한 근거를 검토해 원인을 확인하고 수정 조치를 완료했습니다.
개발 기록 보기

Socket.IO / Kafka / Healthcare CRM

환자 채팅의 메시지 처리와 서버 간 실시간 전달

Socket.IOKafkaRedisRedissonTranslation APIs

문제와 배경

대화 이력은 보존해야 하지만 입력 중 상태는 일시적이고 읽음 여부는 사용자별로 관리해야 했습니다. 이 차이를 기준으로 메시지 저장·이벤트 처리와 실시간 전송을 분리하고 여러 서버에 연결된 사용자를 병원·대화 단위로 연결하도록 설계했습니다.

구현 내용

  • 대화 ID를 기준으로 메시지 이벤트를 발행하고 병원·대화별 접속자에게 전달하도록 구성했습니다. 메시지 처리와 개별 소켓 연결의 수명주기를 분리했습니다.
  • 이전 대화는 메시지 ID 기준으로 나눠 조회하고 입력 중 상태는 별도로 전달했습니다. 읽음 정보는 사용자별 마지막 확인 메시지로 관리해 대화 이력과 구분했습니다.
  • 한국어·영어 대화를 위해 메시지 번역을 연결하고 번역된 내용도 저장해 이후 이력 조회에 사용하도록 했습니다.

SmartDoctor / 주기적 모니터링 / 제품 분석

전 계열사 KPI 대시보드와 data pipeline

PythonPrefectBigQueryAurora MySQLDatadogBackfill

문제와 배경

앱·웹 이용 추세와 사용자 행동을 주기적으로 확인할 수 있도록 BigQuery와 Prefect로 KPI 집계 pipeline을 만들었습니다. DAU·MAU, 체류 시간, 페이지별 이용 패턴을 대시보드에 연결하고 활용 효과를 확인한 뒤 전 계열사에 직접 구축했습니다.

구현 내용

  • BigQuery에 저장된 앱·웹 사용 데이터를 약 한 시간마다 조회·집계하도록 Prefect 작업을 구성하고 Datadog KPI 대시보드를 갱신했습니다.
  • DAU·MAU 추세와 체류 시간·페이지별 이용 패턴을 함께 볼 수 있도록 대시보드를 직접 만들고 전 계열사로 확대했습니다.
  • KPI 이력 재처리·backfill 경로와 대시보드 갱신 도구를 구현했습니다. 병원 DB의 고비용 query·CPU·메모리·단편화 점검도 자동화했습니다.

엔지니어링 프로젝트 / B2B SaaS / 웹·모바일

PharmNote: 약국 영업·운영 플랫폼

KotlinSpring BootPostgreSQLReactReact NativeAWSTerraform
PharmNote 데모 관리자 웹의 제품 관리 화면으로, 제품 분류·기본 단위·현재 가격·활성 상태를 확인합니다.
데모 환경의 기록 화면 · 2026년 8~9월

문제와 배경

영업담당자·본사·매입처가 약국 재고·주문·수금·정산을 함께 관리하는 웹·모바일 플랫폼을 개발했습니다. 종이 장부와 메신저에 흩어진 업무를 하나의 시스템으로 옮기고 백엔드·웹 프론트엔드·모바일 앱·AWS 인프라를 모두 직접 설계·구현했습니다.

PharmNote 보기

구현 내용

  • 차량 판매·본사 창고 출고·공급사 직송마다 재고 이동과 정산 상대를 따로 정의했습니다. 같은 판매 화면을 쓰더라도 거래 경로에 따라 회계 반영 내용이 달라져야 했습니다.
  • 매입원가·내부 출고가·약국 판매가를 구분해 회사와 영업담당자의 이익을 각각 계산했습니다. 거래 시점 값을 보존하고 반품·취소를 원거래에 연결해 이후 상품 가격이 바뀌어도 과거 거래 금액이 달라지지 않도록 설계했습니다.
  • 방문 완료 시 판매·반품·선택한 수금·재고·미수금을 하나의 transaction으로 반영해 현장 업무와 정산 기록이 함께 확정되도록 구현했습니다.
  • 테넌트 인증, 역할·소유권 검사, PostgreSQL 행 수준 정책으로 접근 범위를 제한하고 매입처 화면과 관리자 원가·수익 정보를 분리했습니다.
  • 모바일 작업을 버전 기반 전송 전에 저장하고 처리 결과가 불확실한 수금 재시도를 보존했습니다. 응답이 없다는 이유만으로 수금을 실패로 간주하지 않고 중단된 현장 업무를 이어갈 수 있도록 구성했습니다.

Python / Kubernetes / 정책 조정 / 실행 검증

Cloud Orchestrator: Kubernetes 운영 자동화

PythonKubernetesPrometheusDockerNumPy
합성 snapshot을 표시한 Cloud Orchestrator 제어 개요 화면. 8개 역할, 8개 제안, 확인되지 않은 작업 1건, 미검증 상태의 클라우드 기여도를 보여줍니다.
저장된 대시보드 · 합성 snapshot · 2026년 9월

문제와 배경

서비스 품질과 공급자 자원 효율을 함께 검증할 수 있는 Kubernetes 운영 자동화 시스템을 개발했습니다. 복구·확장·배치 정책이 같은 자원을 서로 다르게 변경할 수 있어 8개 역할의 제안을 중앙에서 검증하고 한 번에 하나씩 실행하도록 설계했습니다. 실행 기록을 영속화해 결과가 불확실한 작업의 재실행을 막고 정책 판단과 성과 측정을 분리했습니다. 두 로컬 cluster에서 baseline과 controller를 비교하는 환경을 구성하고 서비스 확장·워크플로 실행을 검증했습니다.

개발 기록 보기

구현 내용

  • 복구·용량·요청 수락·서비스 크기·배치·워크플로 실행의 담당 역할을 나누고 진단·간섭 분석은 자문으로 제한했습니다. 한 작업이 다음 판단의 전제를 바꾸므로 병렬 실행보다 관측·검증·단일 실행의 순환을 택했습니다.
  • Referee가 관측 시점·권한·SLO·예산을 확인한 제안만 실행하도록 구성했습니다. 실행 전 기록을 영속화하고 게이트웨이에서 상태 버전과 재시도 식별 키를 검증해 결과가 불확실한 작업을 다시 실행하지 않도록 했습니다.
  • 로컬 Kubernetes 환경에서 실제 서비스 확장과 DAG 작업 실행을 확인했습니다. controller·수집기는 조회 권한만 갖고 게이트웨이가 지정 범위의 변경을 담당하며 학습 프로세스에는 cluster 자격 증명을 주지 않았습니다.
  • baseline과 controller를 별도 cluster에 두고 같은 부하의 요청·CPU 지표를 독립 수집하도록 구성했습니다. 결정론적 정책을 기본으로 유지하고 선택형 학습 모델은 실행 가능한 제안의 순위만 조정하며 비교 근거를 통과해야 활성화되도록 했습니다.

개인 실험 / 시장 data pipeline

Quant Trading: 개인 토이 프로젝트

PythonParquetscikit-learn

문제와 배경

재현 가능한 시장 데이터 처리와 신중한 전략 평가를 탐구하는 개인 프로젝트입니다.

구현 내용

  • Databento 정리, 시간 순서 기반 분할, no_trade baseline을 실험했습니다.

SwiftUI / Runtime Safety / Codex MCP

DevBerth: macOS 개발 서비스 관리 도구

SwiftSwiftUISwiftDataMCPDockermacOS
DevBerth 네이티브 런타임 뷰에 로컬 listener와 컨테이너 서비스가 보입니다.
실제 앱 화면 · 2026년 7월 캡처

문제와 배경

로컬 포트·프로세스·Docker 서비스를 확인하고 프로젝트별 서비스를 관리하며 작업 환경을 복원하는 macOS 앱을 개발했습니다. MCP로 Codex가 앱과 같은 제어 기능을 사용하도록 연결하고, 작업 실행 전에 대상의 소유 관계를 다시 확인하도록 설계했습니다.

개발 기록 보기

구현 내용

  • 포트 충돌 때마다 lsof·ps·Docker를 따로 확인하던 불편에서 시작했습니다. 실행 중인 서비스, 검토한 실행 설정, 프로젝트 의존성, 저장한 작업 환경을 한곳에서 다루고 관측 정보와 중지·재시작 권한을 구분했습니다.
  • 모니터링·저장·서비스 제어는 네이티브 앱이 맡고 MCP helper는 Codex 요청을 같은 앱으로 전달하도록 구성했습니다. 설정 버전을 확인하고 파괴적 작업에는 일회용 미리보기를 적용했습니다.
  • 창을 닫은 뒤에도 CPU 사용량이 높은 현상을 Activity Monitor에서 발견했습니다. 처음에는 프로세스 탐색을 의심했지만 Instruments에서 메인 thread의 SwiftUI·AttributeGraph 작업을 확인했고, 내부 카운터로 관측 시각만 바뀐 snapshot이 화면 갱신과 저장을 반복해서 유발한다는 점을 추적했습니다.
  • 관측 시각은 최신성 판단에 유지하되 실제 상태 변경은 따로 비교했습니다. 동일 snapshot 테스트에서 분당 transaction 30회와 저장 이력 변경 3,460건이 쓰기 0건으로 줄었고 취소 가능한 단일 모니터링 루프로 중복 갱신 요청을 합쳤습니다.
  • AppKit의 실제 창 표시·가림 상태에 따라 polling 주기를 조절하고 프로세스·Docker 조회를 묶으며 숨겨진 화면의 불필요한 갱신을 줄였습니다. 유휴 상태의 관측 정보는 최대 30초 전 값일 수 있지만 중지·재시작 시에는 프로세스 식별 정보와 소유 관계를 새로 확인합니다.
  • 같은 Mac에서 메인 창과 메뉴 팝오버를 닫은 Release 빌드를 각각 901초간 비교해 평균 CPU 사용량이 69.2%에서 0.118%로 줄어든 것을 확인했습니다. 당시 앱 전체 테스트 210개가 통과했으며 상세 글에 측정 조건과 남은 전경 화면 멈춤 현상을 함께 기록했습니다.

showmethesanggwon.com / Backend & Frontend / Proptech

상권을 부탁해: 입지 분석 및 매물 추천

KotlinSpring BootReactTypeScriptPostgreSQL

문제와 배경

예비 창업자를 위한 proptech 서비스를 개발했습니다. 서울 상권과 공실 매물을 점수로 비교하고 추천하는 서비스입니다. 입지 분석, 매물 탐색, 추천 API, 지도 기반 UX의 백엔드와 프론트엔드를 구현했습니다.

구현 내용

  • XGBoost 기반 AI 모델을 개발했습니다. 백엔드에서 분석 생성, polling/SSE 진행 상태, Top 3 추천, 공실 검색, 자연어 조건 파싱, horizon score, score explanation, metric reference API를 정리했습니다.
  • 프론트엔드에서 지도 기반 Analyze, 공실 탐색, 상세/히스토리, shortlist/compare, 예산 필터, 자연어 공실 탐색 UX를 구현했습니다.
  • 2026 서울시 빅데이터 활용 경시대회 대상 수상으로 이어진 실전형 창업 프로젝트입니다.

소규모 교내 프로젝트 / 모바일

세모: 여행 동행 앱

KotlinSpring BootReact Native

문제와 배경

여행 동행 찾기, 일정 관리, 채팅을 지원하는 소규모 모바일 프로젝트입니다.

구현 내용

  • Kotlin/Spring Boot API와 React Native 화면을 구현했으며 경희대학교 2026 세모톤에서 우수상을 받았습니다.

SWMaestro / Product Launch / Applied AI

외국인을 위한 한국어 학습 플랫폼

JavaSpring BootFlaskOpenAInginx

문제와 배경

소프트웨어 마에스트로 과정에서 한국어 학습 제품을 만들며 아이디어 기획부터 개발, 배포, 앱 출시까지 수행했습니다.

구현 내용

  • 자막 기반 학습과 말하기 연습을 위한 영상 처리 흐름을 개발했습니다.
  • NLP와 OpenAI API를 활용해 학습 자료에서 단어 예문과 사용 맥락을 추출했습니다.
  • Spring Boot API, Flask 서비스, Nginx 배포, 출시 준비까지 제품 실행 전반을 맡았습니다.

Contracts / Observability / Integration Reliability

신뢰성 도구 및 개발 생산성

OpenAPIFeignSQSKafkaRedisDatadogServiceMonitor

문제와 배경

반복되는 연동 문제를 개별 수정으로 끝내지 않고 백엔드, 메시징, 관측성, 배포 저장소 전반의 명시적인 플랫폼 패턴으로 바꾸는 작업을 했습니다.

구현 내용

  • argument resolver, Feign auth-token client, Secrets Manager/Parameter Store 설정, application/domain 모듈 경계를 통해 병원 스코프 요청 문맥을 표준화했습니다.
  • Swagger/OpenAPI customizer, 예외 사유 문서화, request/response logging, Slack 오류 라우팅, Datadog tracing/metric, ServiceMonitor, Prometheus/Grafana 매니페스트로 운영 가시성을 높였습니다.
  • SQS, Kafka/Debezium, Redis/Redisson, KEDA autoscaling, PDB/HPA, 결제/예약/접수/시술 배정 transactional facade를 중심으로 비동기 연동 경로를 안정화했습니다.

Go / React / PostgreSQL / 실험 재생

PostgreSQL Consistency Lab: 동시성 & 가시성

GoReactTypeScriptPostgreSQLSSEDocker
PostgreSQL Consistency Lab이 완료된 큐 워크로드를 타임라인과 기록된 메트릭과 함께 재생합니다.
로컬 실행 화면 · 2026년 9월 캡처

문제와 배경

재현 가능한 동시성 시나리오를 React 관측 워크스페이스에 연결한 로컬 데이터베이스 랩입니다. 백엔드는 Go API와 PostgreSQL입니다.

개발 기록 보기

구현 내용

  • transaction 액터, lock 검사, query plan, 워크로드 실험, 저장된 재생을 공용 증거 타임라인으로 연결했습니다.
  • 현재 게이지, 구간 속도, 누적 카운터, 부재한 증거를 구분하는 모니터링 뷰를 설계했습니다.
  • 로컬 애플리케이션은 PostgreSQL 16에서 동작하며 엔지니어링 글에 시나리오와 증거의 경계를 문서화했습니다.

기술 스택

프로덕션 시스템과 리서치 pipeline에서 사용한 백엔드, 클라우드, 데이터, 관측성, ML, 프론트엔드 기술입니다.

백엔드

Kotlin

Java

Spring Boot

GraphQL

Hibernate

WebSocket

클라우드

AWS

EKS

Kubernetes

Terraform

Helm

ArgoCD

Istio

GitHub Actions

데이터

PostgreSQL

SQL Server

Redis

Kafka

Debezium

BigQuery

Python

관측성

Prometheus

Grafana

Datadog

Rancher

ML

Python

XGBoost

scikit-learn

Ray

Optuna

Polars

Pandas

NumPy

PyArrow

Feature Engineering

프론트엔드

React

TypeScript

React Native

이력

백엔드 및 클라우드 시스템 엔지니어

문제의 원인을 끝까지 파고들고, 안정적이고 효율적인 서비스를 만드는 백엔드 개발자입니다.

경력

SmartDoctor · 백엔드 연구원

2024.01 - 2026.02. 예약 응답을 2초 → 0.2초로 줄였습니다. 변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄였습니다. 별도 네트워크 지연은 조사와 NCP 기술 미팅을 주도해 수정까지 이끌었습니다. C# → Kotlin 처방 이관에서 SQL·바인딩 값·실행 순서를 비교하는 백오피스를 만들고, 진료비와 연관 데이터의 차이를 추적해 오류 수정 후 1차 450개 케이스를 통과했습니다. 병원 DB가 오프라인이어도 예약을 접수할 수 있도록 Debezium 예약 전달을 구현했습니다. JDBC 문자열 바인딩과 NCHAR 조회 제한을 해결해 DB CPU 사용량을 20% 줄이고 index를 사용하지 못했던 query의 실행 시간을 80% 단축했습니다. EKS 병원 그룹별 배포를 구현했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다. Datadog 전환과 query·index 개선으로 평균 DB 부하를 30% 이상 줄이고 모니터링 비용을 20% 절감했습니다. BigQuery·Prefect KPI 대시보드는 전 계열사로 확장했습니다.

학력

경희대학교

소프트웨어융합대학 컴퓨터공학부 재학. 2027.02 졸업 예정.

프로그램

소프트웨어 마에스트로 14기

2023년 국가 소프트웨어 인재 양성 프로그램에 선발되어 한국어 학습 제품을 end-to-end 팀 프로젝트로 출시했습니다.

수상 및 활동

대상

2026 서울시 빅데이터 활용 경시대회

서울시

교내 우수상

경희대학교 2026 세모톤(SemoThon)

경희대학교

프로그램

소프트웨어 마에스트로 14기

과학기술정보통신부

교육

교내 알고리즘 / 백엔드 교육

경희대학교

교내 수상

경희대학교 가을 팀 경시대회 우수상

경희대학교

대회

경인지역 프로그래밍 경시대회 shake! 10위

경인지역 프로그래밍 경시대회

교내 수상

경희대학교 가을 팀 경시대회 우수상

경희대학교

교내 수상

경희대학교 CTF 보안대회 우수상

경희대학교

교내 수상

경희대학교 봄 프로그래밍 경시대회 동상

경희대학교

추가 자격 및 언어

TOEIC 975

ETS

한국어 / 영어

언어

소개

느린 요청, 레거시 데이터, 불안정한 연결이 맞물린 백엔드 문제를 다룹니다. 문제를 일으키는 제약을 찾아 실제 운영 조건에 맞는 해결책을 만듭니다.

경력

SmartDoctor · 백엔드 연구원

2024.01 - 2026.02. 예약 응답을 2초 → 0.2초로 줄였습니다. 변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄였습니다. 별도 네트워크 지연은 조사와 NCP 기술 미팅을 주도해 수정까지 이끌었습니다. C# → Kotlin 처방 이관에서 SQL·바인딩 값·실행 순서를 비교하는 백오피스를 만들고, 진료비와 연관 데이터의 차이를 추적해 오류 수정 후 1차 450개 케이스를 통과했습니다. 병원 DB가 오프라인이어도 예약을 접수할 수 있도록 Debezium 예약 전달을 구현했습니다. JDBC 문자열 바인딩과 NCHAR 조회 제한을 해결해 DB CPU 사용량을 20% 줄이고 index를 사용하지 못했던 query의 실행 시간을 80% 단축했습니다. EKS 병원 그룹별 배포를 구현했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다. Datadog 전환과 query·index 개선으로 평균 DB 부하를 30% 이상 줄이고 모니터링 비용을 20% 절감했습니다. BigQuery·Prefect KPI 대시보드는 전 계열사로 확장했습니다.

학력

경희대학교

소프트웨어융합대학 컴퓨터공학부 재학. 2027.02 졸업 예정.

프로그램

소프트웨어 마에스트로 14기

2023년 국가 소프트웨어 인재 양성 프로그램에 선발되어 한국어 학습 제품을 end-to-end 팀 프로젝트로 출시했습니다.

프로젝트

SmartDoctor / 백엔드 / 업무 규칙·정합성

진료 규칙과 외부 예약, 레거시 동작을 잇는 백엔드

저사양 병원 PC의 반복 조회 부하, API 밖에서 바뀌는 데이터, PC 종료로 접근할 수 없는 DB를 함께 다뤘습니다. 예약판에는 DB 변경을 감지하는 cache를 적용해 응답을 2초에서 0.2초로 줄였습니다. 변경된 필드만 조회해 해당 API의 클라이언트 데이터 전달량과 Spring Boot 메모리 사용량을 각각 90% 줄였고, 예약 전달은 병원 운영 시간과 분리했습니다. 처방 이관에서는 API 응답에 드러나지 않는 금액·처리 차이를 대조하는 도구를 만들었습니다.

프로젝트 상세 보기

SmartDoctor / 병원별 서비스 분리 / 클라우드 운영

병원별 부하와 운영 조건에 맞춘 클라우드 구조

병원별 Hikari pool이 늘어나 한 pod에 DB 관련 thread 약 900개가 쌓였습니다. 병원 그룹을 직접 설계해 DB 연결·라우팅·배포를 나누고 자원 지표와 운영 담당자의 판단을 바탕으로 주로 수동으로 그룹을 조정했습니다. pod당 Hikari connection pool 수를 평균 2,000개에서 400개로 줄였습니다. 모니터링은 Datadog으로 통합하고 도입·절감 비용을 산정해 비용을 기존의 80%로 낮췄습니다.

프로젝트 상세 보기

Socket.IO / Kafka / Healthcare CRM

환자 채팅의 메시지 처리와 서버 간 실시간 전달

대화 이력은 보존해야 하지만 입력 중 상태는 일시적이고 읽음 여부는 사용자별로 관리해야 했습니다. 이 차이를 기준으로 메시지 저장·이벤트 처리와 실시간 전송을 분리하고 여러 서버에 연결된 사용자를 병원·대화 단위로 연결하도록 설계했습니다.

프로젝트 상세 보기

글 검색

제목, 본문, 태그를 검색합니다.